構建堅實的數據基石 數據處理與存儲支持服務如何賦能大數據時代
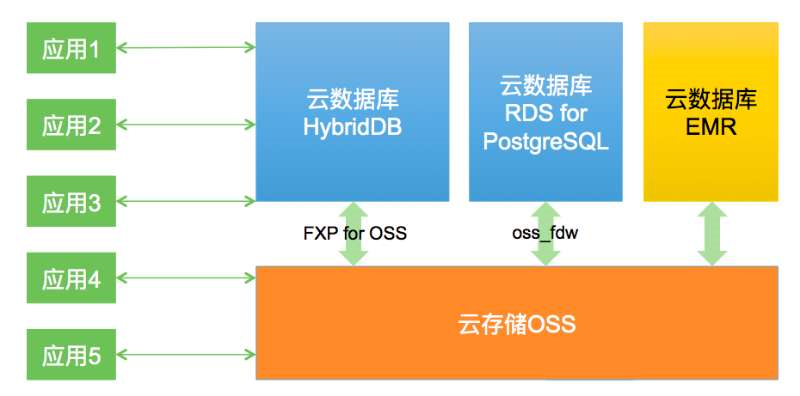
在數字經濟時代,數據已成為核心生產要素。面對海量、多樣、高速增長的數據,企業能否高效地存儲、處理并挖掘其價值,直接決定了其在市場競爭中的成敗。為此,專業的數據處理和存儲支持服務應運而生,其核心使命正是:能夠支持大量的數據存儲和訪問,滿足用戶的大數據處理需求。
一、海量數據存儲:從“存得下”到“存得好”
“支持大量的數據存儲”絕非簡單的容量堆砌。現代存儲支持服務需具備以下關鍵能力:
- 彈性擴展架構:采用分布式存儲系統(如對象存儲、分布式文件系統),支持PB級甚至EB級容量平滑擴展,企業可按需增長,避免前期過度投資。
- 多模態數據兼容:同時支持結構化數據(如關系型數據庫)、半結構化數據(如JSON、日志)和非結構化數據(如圖片、視頻、文檔),滿足不同業務場景的存儲需求。
- 高可靠與高持久性:通過多副本、糾刪碼、跨地域容災等技術,確保數據持久性達到99.999999999%(11個9),保障業務連續性。
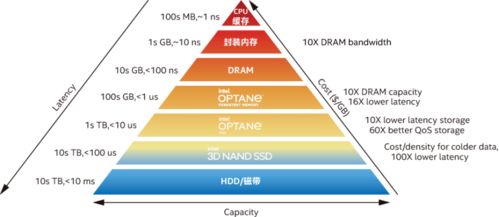
- 分層存儲與成本優化:根據數據訪問頻率自動分層(熱、溫、冷、歸檔),在保證性能的同時顯著降低存儲成本。
二、高效數據訪問:讓數據“觸手可及”
存儲的價值在于訪問。面對大規模數據,高速、穩定的訪問能力是關鍵:
- 高并發低延遲:通過緩存加速、并行讀取、智能預取等技術,支撐數千甚至數萬QPS的并發訪問,滿足實時查詢與分析需求。
- 統一命名空間與全局索引:跨地域、跨集群提供統一訪問入口,用戶無需關心數據物理位置,即可高效檢索與獲取數據。
- 協議兼容與開放接口:支持POSIX、S3、HDFS、NFS等多種標準協議,并提供RESTful API,便于各類應用與大數據組件(如Hadoop、Spark、Flink)無縫集成。
- 數據本地性優化:在計算與存儲分離架構下,通過智能調度將計算任務推向數據所在節點,減少網絡傳輸開銷,提升處理效率。
三、滿足大數據處理需求:存儲與計算的協同
大數據處理不僅需要“存”和“取”,更需要存儲系統與計算引擎深度協同:
- 吞吐量保障:針對批處理場景,提供高聚合帶寬(如數十GB/s),確保海量數據掃描、ETL作業高效運行。
- 元數據管理:高效管理數十億文件/對象的元數據,支持快速列表、重命名、權限校驗等操作,避免元數據服務成為瓶頸。
- 數據一致性與版本控制:在并發寫入與更新場景下,提供強一致性或最終一致性模型,并支持快照、版本回滾,保障數據處理的準確性。
- 安全與合規:集成細粒度訪問控制、傳輸加密、靜態加密、審計日志,滿足數據安全法與行業合規要求。
四、典型應用場景
- 數據湖與湖倉一體:作為統一存儲底座,支撐原始數據沉淀與多引擎分析。
- AI/ML訓練:高速存儲訪問加速海量樣本讀取,縮短模型訓練周期。
- 日志與監控分析:高吞吐寫入與實時檢索,支撐可觀測性平臺。
- 備份與歸檔:低成本冷存儲滿足長期數據留存與合規需求。
五、
數據處理和存儲支持服務是企業大數據戰略的基礎設施。通過構建彈性、可靠、高效、開放的存儲與訪問體系,并持續優化與計算引擎的協同,企業才能真正“存得下、取得到、算得快”,充分釋放數據要素價值,在數字化浪潮中贏得先機。
如若轉載,請注明出處:http://m.zhengxing1000.cn/product/103.html
更新時間:2026-11-09 11:23:22